
Закон об ИИ в России 2026: что требует 243-ФЗ и что сделать бизнесу до 1 марта 2027 года
Разбор федерального закона об ИИ № 243-ФЗ: что действует с 1 сентября 2026 года, что изменится 1 марта 2027-го, как устроено правовое регулирование искусственного интеллекта в России и других странах. С чек-листом в PDF.
Коротко. Закон об ИИ — Федеральный закон № 243-ФЗ о поддержке развития технологий искусственного интеллекта — почти не добавляет обязанностей компаниям, которые просто пользуются нейросетями. Собственных штрафов в нём нет, зарубежные модели он не запрещает, маркировать тексты бизнес не обязан. Главное начнётся 1 марта 2027 года. Правительство получит право назвать сферы, где разрешены только российские модели. Системы, которые к этой дате уже работают и хранят данные в России, получат отсрочку до 1 сентября 2032 года. Поэтому до марта стоит провести инвентаризацию ИИ в компании и принять несколько решений.
Я прочитал закон об искусственном интеллекте целиком, в нём 13 статей, и сверил его с пересказами (не без помощи ИИ). Ниже — что в нём действительно написано, что из этого следует на практике, как устроено правовое регулирование искусственного интеллекта в России, как с ИИ сочетаются правила о персональных данных, как регулируют ИИ в других странах, и чек-лист для самопроверки.
Важно Это разбор для руководителей, а не юридическое заключение. Цитаты взяты из официальных текстов законов, выводы — моё прочтение. Решения по своей компании сверяйте с юристом.
Что такое закон об ИИ 243-ФЗ
Полное название — Федеральный закон от 26.07.2026 № 243-ФЗ «О поддержке развития технологий искусственного интеллекта в Российской Федерации». Законопроект № 1271570-8 внесло Правительство. Госдума приняла его 8 июля 2026 года, Совет Федерации одобрил 17 июля. Текст опубликован на официальном портале правовой информации 26 июля. Историю прохождения можно посмотреть в карточке законопроекта на сайте Госдумы, текст с разбивкой по статьям — в КонсультантПлюс.
Это рамочный закон: он задаёт понятия, принципы и полномочия государства, а конкретные правила оставляет постановлениям Правительства. Название говорит о поддержке, и это точно отражает содержание. Большая часть статей посвящена целям, принципам, полномочиям государства и мерам поддержки разработчиков. Требований к обычному бизнесу немного, но они есть.
Кого касается: только большие фундаментальные модели
Закон регулирует не любой ИИ, а «большие фундаментальные модели искусственного интеллекта». Статья 3 даёт длинное определение. Ключевая часть — о программе:
«…одновременно являющаяся основой для создания и доработки различных видов программного обеспечения, содержащая не менее 1 миллиарда параметров и применяемая для выполнения большого количества различных задач».
Что это значит на практике:
- Попадают под закон универсальные языковые модели, которыми сейчас пользуется бизнес: GigaChat, YandexGPT и Alice AI, ChatGPT, Claude, DeepSeek, Kimi, Qwen и другие крупные модели, в том числе открытые. Все они больше миллиарда параметров и решают множество задач.
- Не попадают узкие модели машинного обучения: скоринг, прогноз спроса, антифрод, распознавание объектов на изображениях, чат-бот по заранее заданному сценарию. Они либо меньше порога, либо решают одну задачу.
- Пограничный случай — компактные открытые модели меньше 1 млрд параметров. Формально они вне закона, даже если работают как универсальный ассистент.
Если вы встроили GigaChat или другую крупную модель в ассистента для клиентов, ваш продукт применяет большую фундаментальную модель. Значит, часть норм ниже относится к вам.
Когда вступает в силу закон об ИИ: 1 сентября 2026 и 1 марта 2027 года
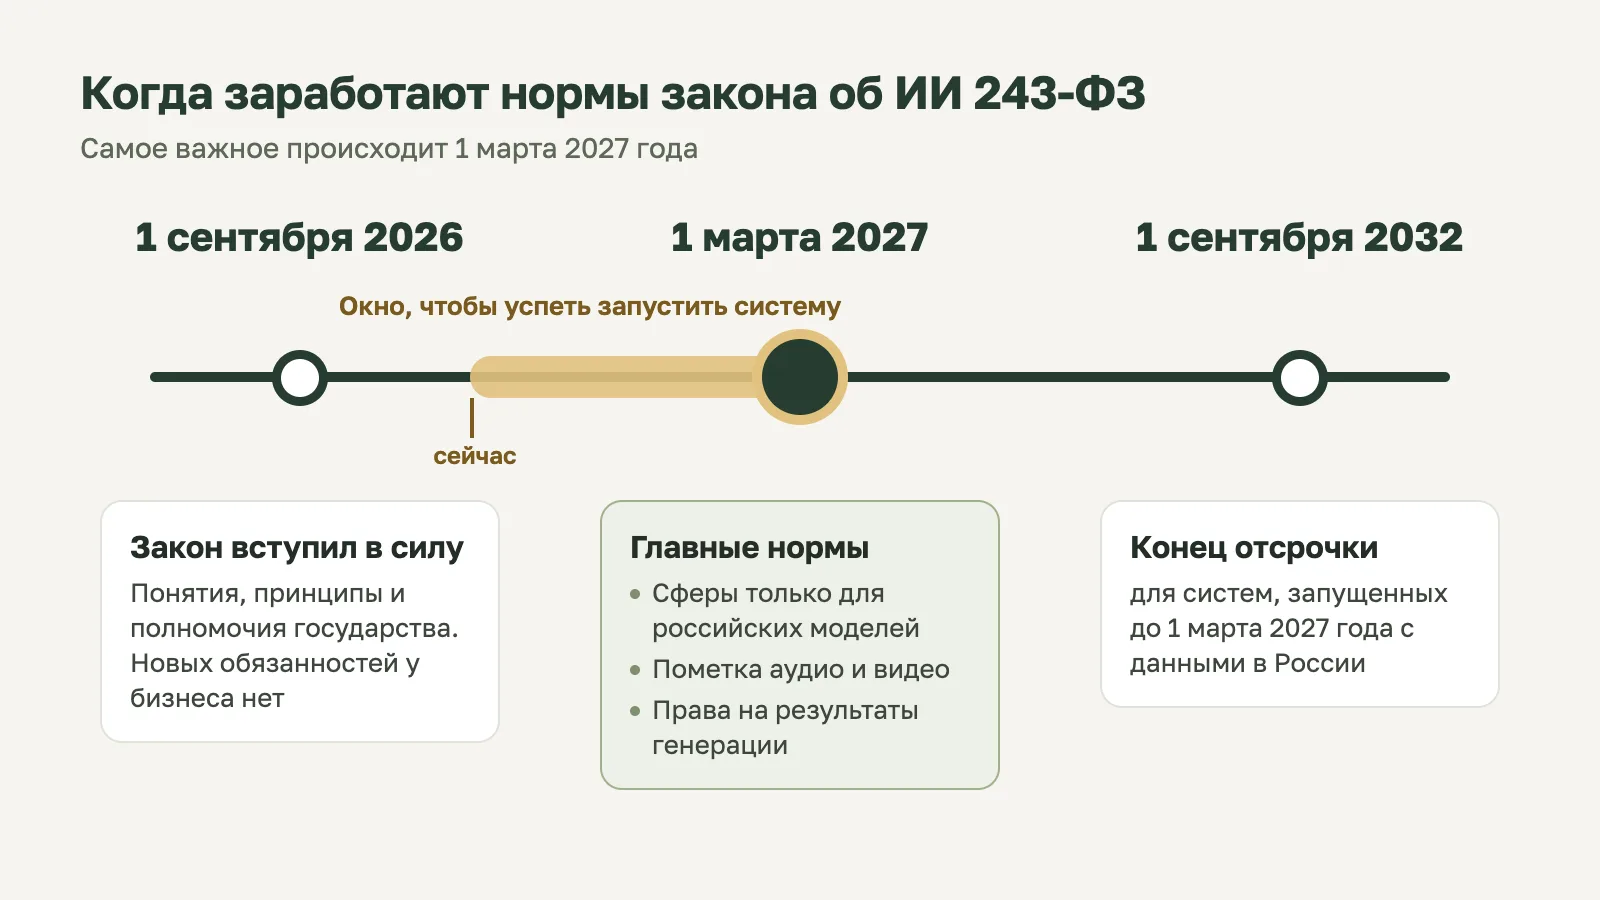
Закон вступил в силу 1 сентября 2026 года, но самые практичные нормы отложены. Сроки установлены статьёй 13. Главные даты — на схеме. Ниже в таблице — что меняется простыми словами и кому это важно.
| Что меняется | Кому важно | Когда |
|---|---|---|
| В законе появляются понятия «искусственный интеллект», «большая фундаментальная модель», «разработчик модели», принципы регулирования и полномочия госорганов (ст. 1–5, 7, 11, 12). Новых обязанностей для бизнеса это не создаёт | Всем как рамка: на эти определения будут ссылаться следующие акты | С 1 сентября 2026 |
| Правительство сможет назвать сферы, где разрешены только суверенные или национальные модели (п. 3 ч. 2 ст. 5) | Госсектору и подрядчикам госзаказчиков, КИИ, образованию, медицине, финансам | С 1 марта 2027 |
| Правительство сможет вводить отраслевые требования к рискам ИИ, в финансах — вместе с Банком России (п. 4 ч. 2 ст. 5) | Отраслям, которые выберет Правительство | С 1 марта 2027 |
| Разработчики суверенных и национальных моделей получат доступ к данным госсистем для обучения (п. 5 ч. 2 ст. 5) | Разработчикам моделей | С 1 марта 2027 |
| Появляются статусы «суверенная» и «национальная» модель и порядок их присвоения (ч. 2–5 ст. 6) | Тем, кто выбирает, на какой модели строить продукт | С 1 марта 2027 |
| Разработчики суверенных и национальных моделей обязаны обеспечивать безопасность, утвердить правила эксплуатации и вести документацию (ст. 8) | Только разработчикам таких моделей | С 1 марта 2027 |
| Авторы аудио и видео, созданных ИИ, получают возможность поставить пометку об этом. Крупные площадки обязаны дать такую возможность (ст. 9) | Тем, кто публикует ИИ-ролики и изображения; площадкам с аудиторией больше 500 тысяч в сутки | С 1 марта 2027 |
| Нужно сообщать пользователям, кому принадлежат права на сгенерированное и на каких условиях хранятся результаты (ч. 1 ст. 10) | Всем, кто встроил крупную модель в продукт для клиентов | С 1 марта 2027 |
| Суверенные и национальные модели можно обучать на открытых чужих текстах и изображениях без согласия правообладателя (ч. 2 ст. 10) | Владельцам сайтов и контента | С 1 марта 2027 |
| Системы, которые работают на 1 марта 2027 года и хранят данные в России, освобождены от ограничений по выбору модели (ч. 3 ст. 13) | Тем, кто запускает ИИ-проекты сейчас | До 1 сентября 2032 |
Суверенная и национальная модель: в чём разница
Статья 6 вводит два статуса. Общие требования у них такие:
- разработчик — российское юридическое лицо;
- ответы пользователям готовятся, а данные хранятся в дата-центрах на территории России, которые принадлежат российским компаниям;
- модель прошла подтверждение соответствия законодательству и «традиционным российским духовно-нравственным ценностям» в порядке, который установит Правительство.
Различаются статусы степенью самостоятельности разработчика:
- Суверенная модель. Разработчик сам определяет и меняет её характеристики на всех стадиях и может полностью воспроизвести цикл разработки, включая обучение.
- Национальная модель. Существенные характеристики — структуру, программное обеспечение, настраиваемые параметры — определяет российский разработчик. При этом в основе могут быть компоненты под открытой лицензией, в том числе чужие открытые модели.
Российским юрлицом закон считает компанию, где более 50% голосов прямо или косвенно контролируют государство, регионы, муниципалитеты или граждане России без второго гражданства.
По данным «Коммерсанта», под определение суверенной сейчас подходит только GigaChat, а пример национальной — Alice AI от Яндекса. Официально статусы ещё никому не присвоены. Порядок присвоения готовит Минцифры, и на 19 ноября 2026 года утверждённого документа я не нашёл. Для национальной модели обсуждаются критерии: российскому разработчику должны принадлежать исключительные права на обучаемые параметры, архитектуру и код обучения.
Главный пункт: где могут обязать использовать российские модели
С 1 марта 2027 года Правительство получает полномочие по п. 3 ч. 2 ст. 5:
«…устанавливает случаи, в которых допускается применение исключительно суверенных больших фундаментальных моделей искусственного интеллекта и (или) национальных больших фундаментальных моделей искусственного интеллекта (в банковской сфере и иных сферах финансового рынка — по согласованию с Центральным банком Российской Федерации), а также перечень исключений из таких случаев».
Утверждённого перечня случаев пока нет. В сентябре «Коммерсант» описал проект постановления, который обсуждали в рабочей группе по регулированию ИИ. По этому проекту российские модели станут обязательными:
- при подготовке документов стратегического планирования, госпрограмм и нацпроектов, а также нормативных актов госорганов;
- в налоговой, таможенной и бюджетной сферах;
- на объектах критической информационной инфраструктуры (КИИ);
- в образовании, здравоохранении и госуслугах.
Там же предлагалось правило: выбирать суверенную модель, если она дороже национальной не больше чем в полтора раза. В Минцифры при этом ответили, что «говорить о сформированном перечне сфер обязательного применения преждевременно». Так что это ориентир, а не окончательный список.
Если ваша компания работает в одной из этих сфер или выполняет проекты для госзаказчиков, к теме стоит отнестись серьёзно уже сейчас.
Отсрочка до 2032 года: почему важно запуститься до марта
Эту норму пересказы почти не замечают, хотя для бизнеса она самая практичная. Часть 3 статьи 13:
«Случаи, в которых допускается применение исключительно суверенных и (или) национальных больших фундаментальных моделей искусственного интеллекта и которые установлены в соответствии с пунктом 3 части 2 статьи 5 настоящего Федерального закона, до 1 сентября 2032 года не распространяются на информационные системы, в которых применяются большие фундаментальные модели искусственного интеллекта, созданные и (или) эксплуатируемые на день вступления в силу пункта 3 части 2 статьи 5 настоящего Федерального закона, при условии обработки и хранения данных на территории Российской Федерации».
Пункт 3 части 2 статьи 5 вступает в силу 1 марта 2027 года. В переводе на практический язык:
- Если система с крупной моделью создана или работает на 1 марта 2027 года, ограничения из будущего перечня не распространяются на неё до 1 сентября 2032 года. Даже если её сферу потом включат в перечень.
- Условие одно: данные обрабатываются и хранятся в России. Ассистент на открытой модели, развёрнутой в российском дата-центре, этому условию отвечает. Решение, которое отправляет запросы в зарубежный облачный API, по буквальному смыслу нормы — нет.
- Что считается «созданной или эксплуатируемой» системой, закон не уточняет. Я бы зафиксировал дату ввода в эксплуатацию документами: приказом, актом, журналом работы системы.
Если вы планировали ИИ-проект в образовании, медицине, госсекторе или на объектах КИИ, разумно довести его до работающей версии на российской инфраструктуре до 1 марта 2027 года. Это даёт пять с половиной лет на спокойный переход вместо срочной замены модели.
Маркировка: обязанности у бизнеса почти нет
Маркировке посвящена статья 9. Вопреки многим заголовкам, она не обязывает компании помечать всё, что создано нейросетью.
- Речь идёт только о материалах «в аудио- и (или) визуальной форме». Тексты под норму не попадают.
- Тому, кто создаёт такие материалы с помощью крупной модели, «обеспечивается возможность» разместить предупреждение о применении ИИ. Это право, а не обязанность. Формат и порядок размещения определяются соглашением с сервисом, через который вы пользуетесь моделью.
- Обязанность есть у крупных площадок, где пользователи ведут свои страницы и куда за сутки заходят более 500 тысяч человек из России. Они должны дать авторам техническую возможность поставить такую пометку.
Как это выглядит на практике, видно по площадкам, где такие механизмы уже есть:
- Пометка на площадке. На YouTube при загрузке ролика в Творческой студии есть вопрос об изменённом или синтетическом контенте. Если отметить, что реалистичное видео создано или изменено с помощью ИИ, под роликом появится пометка. Порядок описан в справке YouTube. Российские площадки по 243-ФЗ должны будут дать авторам похожую кнопку. В VK в июне 2026 года высказались за маркировку сгенерированного контента.
- Пометка от сервиса генерации. Именно об этом говорит «соглашение с сервисом» из ч. 2 ст. 9. Например, Шедеврум на бесплатном тарифе ставит на картинки водяной знак, а подписка позволяет скачивать без него. Перед тем как выпускать рекламный ролик или баннер из нейросети, проверьте в условиях сервиса, ставит ли он пометку, можно ли её убрать и разрешено ли коммерческое использование результата.
Отдельно в Госдуме обсуждали законопроект об обязательной маркировке ИИ-видео: метка на весь ролик и машиночитаемая отметка в файле. О нём писал «Коммерсантъ» в декабре 2025 года. Принятым его на 19 ноября 2026 года я не нашёл, но направление понятное: требования к видео, скорее всего, станут строже.
Права на результаты генерации: обязанность для тех, кто даёт доступ к модели
С 1 марта 2027 года по части 1 статьи 10 лица, «предоставляющие возможность применения» больших моделей, обязаны уведомить пользователя:
«1) о принадлежности прав на результаты интеллектуальной деятельности, полученные с помощью большой фундаментальной модели искусственного интеллекта;
2) об условиях обеспечения пользователю доступа, использования и сохранения (при наличии технической возможности) созданных с помощью большой фундаментальной модели искусственного интеллекта результатов интеллектуальной деятельности».
Норма касается любых крупных моделей, а не только российских. Кто именно «предоставляет возможность применения», закон не раскрывает. При буквальном прочтении сюда попадают не только разработчики моделей, но и компании, которые встроили модель в свой продукт: ИИ-ассистент на сайте, генератор текстов или изображений в сервисе, бот для клиентов в Telegram.
Что сделать: добавить в оферту, пользовательское соглашение или договор раздел о том, кому принадлежат права на сгенерированное и сколько вы храните результаты. Это несложно и снимает вопрос.
Кому принадлежат права, закон при этом не решает. По-прежнему действует статья 1228 ГК РФ: автором признаётся гражданин, творческим трудом которого создан результат. Нейросеть автором быть не может. А результат простого запроса без творческого вклада человека может вообще не получить защиты авторского права. Поэтому в договорах с подрядчиками и агентствами, которые используют ИИ, стоит отдельно прописать передачу прав и гарантии.
Часть 2 той же статьи разрешает обучать суверенные и национальные модели на чужих произведениях без согласия правообладателя. Условие — разработчик получил экземпляр правомерно, или объект авторского права «был доведен до всеобщего сведения и доступен для анализа без ограничения техническими средствами». Для владельцев сайтов это значит, что открытые тексты могут попасть в обучение российских моделей. Если вы этого не хотите, нужны технические ограничения доступа. Какие именно средства закон считает достаточными, пока не уточнено.
Чего нет в законе об ИИ
- Собственных штрафов. Статья 11 отсылает к общему законодательству: ответственность наступает «в соответствии с законодательством Российской Федерации».
- Запрета зарубежных моделей. Ограничения появятся только в тех случаях, которые определит Правительство.
- Обязательной сертификации для компаний, которые пользуются ИИ. Подтверждение соответствия касается моделей, претендующих на статус суверенной или национальной.
- Обязанностей для пользователей моделей по статье 8. Меры безопасности, правила эксплуатации и техническая документация — обязанность разработчиков суверенных и национальных моделей.
- Правил о персональных данных. 243-ФЗ их не меняет, поэтому для проектов с ИИ главными остаются требования 152-ФЗ. О них — следующий раздел.
Правовое регулирование искусственного интеллекта в России
Закон об искусственном интеллекте в России — не единственный документ, который касается ИИ. Регулирование искусственного интеллекта складывается из нескольких слоёв:
- Стратегия. Национальная стратегия развития искусственного интеллекта на период до 2030 года, утверждённая Указом Президента № 490 в 2019 году и обновлённая в феврале 2024-го. Она задаёт цели государства, но обязанностей для бизнеса не создаёт.
- Рамочный закон. 243-ФЗ: понятия, принципы, статусы российских моделей и полномочия Правительства. Подробно о нём — выше.
- Экспериментальные правовые режимы. Закон 258-ФЗ позволяет временно менять правила для отдельных проектов с ИИ. 243-ФЗ прямо разрешает так настраивать нормы о понятиях и статусах моделей (ч. 4 ст. 13).
- Общие законы. О персональных данных (152-ФЗ), об информации (149-ФЗ), о коммерческой тайне (98-ФЗ), часть четвёртая ГК РФ об интеллектуальных правах. На практике проекты с ИИ чаще всего ограничивают именно они, подробнее — ниже.
- Добровольные правила. Кодекс этики в сфере искусственного интеллекта 2021 года. Он носит рекомендательный характер, к нему присоединились Сбер, Яндекс, VK и сотни других организаций.
Проблемы правового регулирования искусственного интеллекта
Закон закрыл не все вопросы. Главные пробелы, с которыми сталкивается бизнес:
- Права на результат. Кому принадлежит сгенерированный текст или изображение, закон не решает, а ГК признаёт автором только человека.
- Ответственность за ошибки ИИ. Собственных правил нет, ст. 11 отсылает к общему законодательству.
- Кто обязан уведомлять пользователей. Кто именно «предоставляет возможность применения» модели, закон не раскрывает.
- Статусы моделей. Критерии суверенных и национальных моделей и перечень сфер, где они обязательны, ещё не утверждены.
- Решения о людях. Специальных правил для ИИ в найме, кредитовании и других решениях о людях нет, действуют только 152-ФЗ и трудовое право.
Новые законопроекты об ИИ: что может измениться
Многое в законе об ИИ определят постановления Правительства: порядок присвоения статуса моделям и перечень сфер, где разрешены только российские модели. На 20 ноября 2026 года их проекты обсуждаются, но не утверждены.
Кроме того, в октябре КонсультантПлюс опубликовал проект закона «О безопасном использовании систем искусственного интеллекта». Его подготовила группа по законодательству в сфере ИИ при Совете Федерации. Это проект для обсуждения, а не принятый закон, но он показывает направление: реестр доверенных систем ИИ, запрет принимать решения с юридическими последствиями исключительно автоматически, обязательная пометка результатов работы ИИ. Если похожие нормы примут, требований к бизнесу станет больше.
Персональные данные и нейросети: где проходит граница
На практике именно здесь у бизнеса больше всего рисков, и именно здесь больше всего путаницы. Разберу по шагам.
Что считается персональными данными
По п. 1 ст. 3 152-ФЗ персональные данные — это «любая информация, относящаяся к прямо или косвенно определенному или определяемому физическому лицу». Значит, дело не в формате, а в том, можно ли понять, о ком речь.
- Персональные данные: текст с именем и телефоном клиента, фото человека, скриншот карточки из CRM, резюме, запись или расшифровка звонка, переписка с покупателем.
- Не персональные данные: текст для сайта без упоминания людей, фото товара, таблица продаж по категориям без клиентов.
- Серая зона: текст без имени, по которому человека всё равно можно узнать из контекста. Например, «главбух нашего филиала в Туле». Безопаснее считать это персональными данными.
Отдельная ловушка — «обезличивание» заменой имён на коды, когда у компании остаётся таблица соответствий. По п. 9 ст. 3 152-ФЗ обезличивание — это действия, после которых невозможно «без использования дополнительной информации определить принадлежность персональных данных конкретному субъекту». Закон и после обезличивания называет такие данные персональными: пока у компании есть таблица соответствий, человека можно восстановить.
Что считается трансграничной передачей
По п. 11 ст. 3 152-ФЗ это «передача персональных данных на территорию иностранного государства органу власти иностранного государства, иностранному физическому лицу или иностранному юридическому лицу». Из определения следуют три признака, которые должны совпасть: передаются именно персональные данные, они попадают на территорию другой страны, включая серверы, и получатель — иностранное лицо. Если зарубежный сервис персональных данных не получает, трансграничной передачи нет.
Отсюда понятно, как оценивать типичные ситуации:
- Человек сам пишет в зарубежный чат-бот по личным делам. Закон о персональных данных здесь не действует: ч. 2 ст. 1 152-ФЗ исключает обработку «исключительно для личных и семейных нужд».
- Сотрудник по работе вставляет в зарубежный чат-бот данные клиентов или коллег. Это уже обработка от имени компании, и компания отвечает за неё как оператор. Формально это трансграничная передача со всеми требованиями ниже. Чаще всего такие передачи никто не оформлял, и это основной источник риска.
- Клиент загружает текст или фото в ваш сервис, сервис отправляет их в зарубежную модель через API, результат возвращается и сохраняется в личном кабинете на российском сервере. Если в загруженном есть персональные данные, отправка в API — трансграничная передача: данные ушли на зарубежные серверы иностранной компании. То, что результат вернулся и хранится в России, этого не отменяет — передача уже состоялась. Если в загруженном нет персональных данных, например это фото товара, трансграничной передачи нет.
- Тот же сервис, но модель работает в России — у российского провайдера или на вашем сервере. Трансграничной передачи нет, остаются обычные требования 152-ФЗ: основание обработки, политика, защита данных.
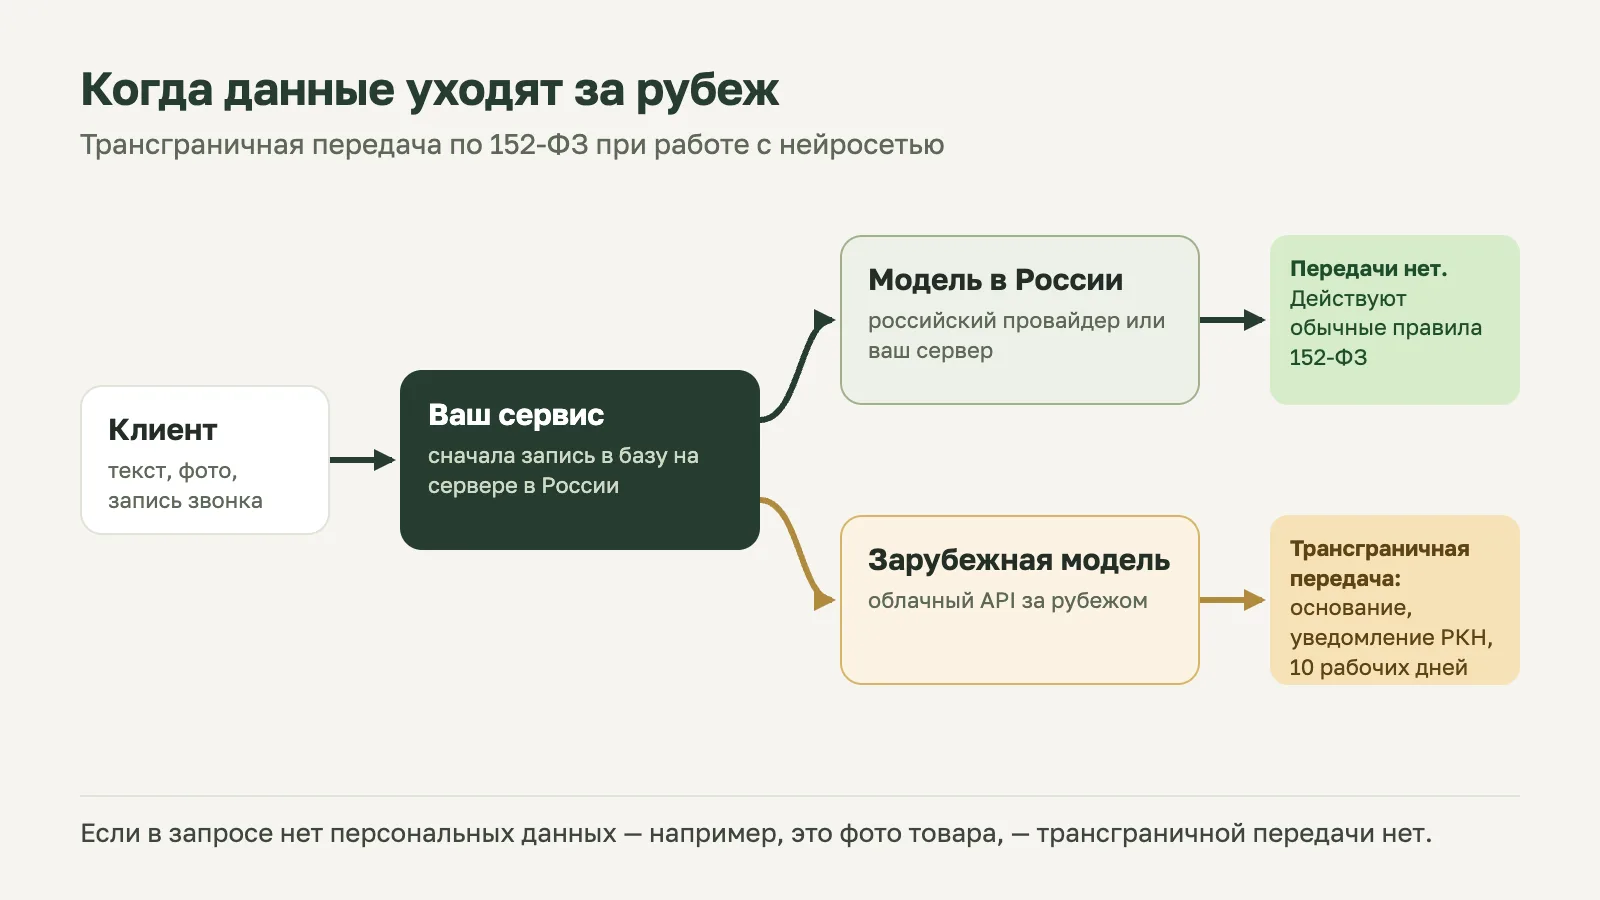
Порядок для трансграничной передачи задаёт ст. 12 152-ФЗ. Сначала данные нужно собрать в российскую базу: ч. 5 ст. 18 запрещает при сборе записывать их «с использованием баз данных, находящихся за пределами территории Российской Федерации». Затем до начала передачи — уведомить Роскомнадзор. Если страна получателя не входит в перечень стран с адекватной защитой данных, а США в него не входят, после уведомления нужно ждать 10 рабочих дней: за это время ведомство может запретить или ограничить передачу. С 26 июля 2026 года страна считается «адекватной» только по перечню Роскомнадзора, участия в конвенции Совета Европы для этого больше недостаточно.
Что будет, если не уведомить
Отдельного штрафа именно за трансграничную передачу без уведомления в ст. 13.11 КоАП нет. Нарушение квалифицируют по общим составам, и итог зависит от обстоятельств:
- обработка в случаях, не предусмотренных законом (ч. 1) — для юрлица от 150 до 300 тыс. рублей;
- неуведомление Роскомнадзора о намерении обрабатывать персональные данные (ч. 10) — от 100 до 300 тыс. рублей;
- если данные клиентов сразу попадали в зарубежный сервис, минуя российскую базу, это нарушение локализации (ч. 8) — от 1 до 6 млн рублей, повторно (ч. 9) — от 6 до 18 млн.
Кроме штрафа, Роскомнадзор может выдать предписание и запретить передачу. Уголовной статьёй 272.1 УК, которой часто пугают в обзорах, обычная работа компании с клиентскими данными не охватывается: она касается данных, полученных «путем неправомерного доступа» или «иным незаконным путем».
Практический вывод: если нейросеть должна работать с данными клиентов или сотрудников, проще всего выбрать модель, которая работает в России, или убирать персональные данные из запроса до отправки. Если без зарубежной модели не обойтись, нужны основание для передачи, уведомление Роскомнадзора и выдержанный срок.
Автоматические решения о людях: пример со скорингом откликов
Ст. 16 152-ФЗ запрещает принимать решения, которые порождают юридические последствия для человека «или иным образом затрагивающих его права и законные интересы», только на основании автоматизированной обработки его данных. Исключения — письменное согласие человека или прямое указание федерального закона. Если такое решение принято, человеку нужно объяснить порядок, дать возможность возразить и рассмотреть возражение за 30 дней.
Возьмём частый случай: работодатель получает сотни откликов, и система оценивает резюме автоматически. Однозначного ответа, нарушает ли это закон, нет: разъяснений Роскомнадзора или Минтруда именно по ИИ-отбору я не нашёл. Но можно рассуждать по признакам.
- Система сама отказывает кандидату, и человек отказ не видит. Это похоже на решение «исключительно» автоматизированное, и оно затрагивает интересы кандидата. Без его письменного согласия риск нарушить ст. 16 высокий.
- Система только сортирует, а рекрутер просматривает всех или может открыть отсеянных. Решение принимает человек, риск ниже.
- Серая зона: система отсекает 80% откликов по проходному баллу, а рекрутер выбирает из оставшихся 20%. Формально финальное решение за человеком, но допуск к рассмотрению фактически решила машина.
Есть и трудовое право. По ст. 64 ТК РФ запрещён необоснованный отказ в приёме на работу. По письменному требованию кандидата работодатель обязан за семь рабочих дней письменно сообщить причину отказа, а отказ можно обжаловать в суде. Ответ «так решила система» причиной не будет: нужно объяснить, каким деловым качествам кандидат не соответствует.
Вопросы, которые я бы обсудил с юристом до запуска такого отбора:
- Видит ли человек кандидатов, которых система отсеяла, и может ли вернуть их?
- Есть ли в форме отклика согласие на автоматизированную оценку и объяснение, как она работает?
- Как кандидат может возразить против оценки, и кто рассматривает возражения?
- Какую причину отказа мы сообщим по ст. 64 ТК, если кандидат её запросит?
- Не отсекает ли модель людей по признакам, которые ст. 64 ТК запрещает учитывать, например по возрасту или месту жительства?
Тема в развитии: на портале «Российская общественная инициатива» идёт голосование за запрет работодателям использовать ИИ для первичного отбора резюме. Это пока инициатива, а не законопроект.
Коммерческая тайна
98-ФЗ защищает информацию, только если компания принимает меры по её охране. Если сотрудники свободно вставляют конфиденциальные документы в публичные чат-боты, отстаивать режим коммерческой тайны потом будет сложнее.
Чек-лист по закону об ИИ: что сделать до 1 марта 2027 года
- Составьте реестр ИИ в компании. Какие модели и сервисы используются, кем, для каких задач и где физически обрабатываются запросы. Учтите и неформальное использование: сотрудники часто работают в публичных чат-ботах без ведома руководства.
- Отметьте, где применяются большие фундаментальные модели. Универсальные языковые модели почти всегда попадают под закон, узкие ML-модели — нет.
- Проверьте свою сферу. Госсектор и проекты для госзаказчиков, КИИ, образование, здравоохранение, финансы, налоговые и таможенные задачи — зона, где ограничения вероятнее всего. Для таких систем решите, запускать ли их до 1 марта 2027 года на российской инфраструктуре, чтобы получить отсрочку до 2032 года. Дату ввода зафиксируйте документами.
- Найдите, куда уходят персональные данные. Данные клиентов и сотрудников сначала записываются в российскую базу. Для передачи в зарубежную модель нужны основание, уведомление Роскомнадзора и выдержанный срок. Помните, что «обезличенные» данные с таблицей замен по-прежнему персональные.
- Оставьте решения о людях за человеком. Отбор кандидатов, отказы клиентам, оценка сотрудников — пусть итоговое решение принимает сотрудник, а система помогает.
- Обновите документы для клиентов. Если клиенты пользуются вашим ассистентом или генерацией, добавьте в оферту или соглашение условия о правах на результаты и их хранении.
- Пересмотрите договоры. С ИИ-провайдером: где обрабатываются данные, кому принадлежат результаты, как ставится пометка о применении ИИ. С подрядчиками: передача прав на материалы, созданные с помощью ИИ.
- Введите внутренние правила. Какие сервисы разрешены, какие данные в них нельзя передавать, кто проверяет результат перед отправкой клиенту.
- Заложите возможность сменить модель. Если перечень обязательных случаев затронет вас, переход на другую модель должен занимать недели, а не переписывание системы. Для этого обращение к модели выносят в отдельный слой, а качество ответов проверяют на своём наборе тестовых вопросов.
- Следите за подзаконными актами. Ждём порядок присвоения статуса моделям и перечень случаев обязательного применения.
Чек-лист в PDF Скачайте чек-лист на одной странице, распечатайте и отметьте, что уже сделано.
Регулирование искусственного интеллекта в других странах
Россия выбрала мягкий вариант: поддержка разработчиков, минимум обязанностей для пользователей и упор на суверенные модели. Для сравнения — как обстоят дела в странах, с которыми работает российский бизнес. Данные на 19 ноября 2026 года.
- Европейский союз, включая Францию, Германию и Испанию. Действует единый регламент об ИИ (AI Act). Он делит системы по уровню риска, запрещает отдельные практики и требует маркировать синтетический контент. В 2026 году ЕС отложил требования к системам высокого риска, например к отбору персонала и кредитному скорингу, до 2 декабря 2027 года. Отдельных законов об ИИ у Франции, Германии и Испании нет, регламент действует напрямую, а страны назначают надзорные органы. В Испании это специальное агентство AESIA. AI Act касается и российских компаний, если результат работы их ИИ используется в ЕС.
- США. Федерального закона об ИИ нет. В декабре 2025 года вышел президентский указ № 14365 о единой национальной политике: он нацелен на то, чтобы оспаривать «обременительные» законы штатов. Тем временем штаты принимают свои законы. Например, в Калифорнии с 1 января 2026 года действует закон о прозрачности передовых моделей ИИ (SB 53). Он касается только разработчиков самых мощных моделей — обученных с объёмом вычислений больше 1026 операций. Они должны публиковать отчёт о каждой новой модели: для чего она предназначена и какие у неё ограничения. Крупнейшие из них, с выручкой больше 500 млн долларов в год, дополнительно раскрывают, как оценивают и снижают катастрофические риски, сообщают властям штата о серьёзных инцидентах с безопасностью за 15 дней, а при прямой угрозе — за 24 часа, и защищают сотрудников, которые сообщают о рисках. Штраф — до 1 млн долларов за нарушение, взыскивает генеральный прокурор штата. Компаниям, которые только пользуются такими моделями, закон обязанностей не добавляет.
- Китай. Единого закона нет, но правил много и они конкретные. С 1 сентября 2025 года действуют меры по маркировке сгенерированного контента: видимая пометка для пользователя и скрытая метка в метаданных файла. С 1 января 2026 года нормы об ИИ появились в обновлённом законе о кибербезопасности.
- Великобритания. Отдельного закона об ИИ нет, и в программу правительства на 2026 год он не вошёл. Ставка на отраслевых регуляторов и «песочницы» для тестирования ИИ-продуктов. Обзор подходов — в материале библиотеки Палаты лордов.
- Казахстан. С 18 января 2026 года действует закон «Об искусственном интеллекте». Он заметно строже российского в части прозрачности. Статья 21 требует сообщать пользователям, что товар или услуга сделаны с помощью ИИ. Распространять синтетический контент можно только с машиночитаемой маркировкой и видимым предупреждением.
- ОАЭ. Федерального закона об ИИ нет. Действует необязательная Хартия разработки и использования ИИ 2024 года с 12 принципами, а летом 2026 года объявлено о создании федерального органа по ИИ и данным. Обязательные требования пока появляются по отраслям и в свободных экономических зонах, например в финансовом центре DIFC.
- Турция. Закона об ИИ нет. В парламенте несколько законопроектов, самый ранний — № 2/2234 — с 2024 года находится в комитете. По данным турецких юристов, в августе 2026 года утверждён национальный план действий по ИИ на 2026–2030 годы, но это стратегия, а не закон.
- Таиланд. Агентство ETDA подготовило проект закона об ИИ с делением систем по уровню риска. Публичное обсуждение закончилось 14 августа 2026 года, решения правительства пока нет. Разбор проекта — у Baker McKenzie.
- Индонезия. Закона нет. Готовятся два указа президента — об этике ИИ и о национальной дорожной карте. В сентябре 2026 года министерство цифровизации сообщило, что они ждут подписи президента.
Общая картина: жёсткие правила с маркировкой и классами риска приняли ЕС, Китай и Казахстан. США, Великобритания, ОАЭ и Россия пока регулируют точечно и больше полагаются на действующие законы о данных и защите потребителей. Если вы работаете с клиентами в ЕС или Казахстане, проверьте требования к маркировке там — они строже российских.
Частые вопросы о законе об ИИ
Принят ли закон об ИИ в России?
Да. Федеральный закон от 26.07.2026 № 243-ФЗ подписан 26 июля 2026 года и вступил в силу 1 сентября 2026 года. Часть норм заработает 1 марта 2027 года.
Что изменилось с 1 сентября 2026 года?
Вступили в силу понятия, принципы и полномочия государства. Новых обязанностей у компаний, которые пользуются нейросетями, с этой даты не появилось: практические нормы заработают 1 марта 2027 года.
Что значит «рамочный закон об ИИ»?
Закон задаёт понятия, принципы и полномочия. Конкретные правила, например в каких сферах нужны только российские модели, Правительство устанавливает отдельными постановлениями.
Нужно ли маркировать тексты, написанные нейросетью?
По 243-ФЗ — нет. Статья 9 говорит только об аудио- и визуальных материалах, и для бизнеса это возможность, а не обязанность.
Можно ли пользоваться ChatGPT или Claude после 1 марта 2027 года?
Закон этого не запрещает. Ограничения появятся только в случаях, которые определит Правительство. Но правила о персональных данных действуют уже сейчас: отправлять данные клиентов в зарубежный сервис можно только с соблюдением 152-ФЗ.
Сотрудник вставил в зарубежный чат-бот договор с данными клиента. Это нарушение?
Скорее всего, да. Это обработка персональных данных от имени компании и их передача иностранному получателю. Для этого нужны основание, уведомление Роскомнадзора и выдержанный срок. Без этого компании грозят штрафы по ст. 13.11 КоАП. Проще всего запретить такие действия внутренними правилами и дать сотрудникам разрешённый инструмент.
Нарушает ли закон автоматический отбор резюме?
Зависит от того, кто принимает решение. Если система сама отказывает кандидатам без участия человека, это рискованно по ст. 16 152-ФЗ. Если система сортирует, а решение за рекрутером, риск ниже. Схему отбора стоит обсудить с юристом до запуска.
Какие штрафы предусмотрены?
Своих штрафов в 243-ФЗ нет. Ответственность наступает по действующим законам, например по ст. 13.11 КоАП за нарушения в работе с персональными данными.
Касается ли закон нашей модели прогноза продаж?
Скорее всего, нет. Закон регулирует универсальные модели от 1 млрд параметров. Узкая модель для одной задачи под определение не попадает.
Наша система работает на зарубежной модели. Что будет?
Пока ваша сфера не попала в перечень Правительства, ничего не меняется. Если попадёт, отсрочка до 1 сентября 2032 года возможна только при обработке и хранении данных в России. Решение на зарубежном облачном API этому условию, по буквальному тексту закона, не отвечает. Его придётся переводить на другую модель.
Как мы учитываем это в проектах
Когда мы проектируем ИИ-решения, юридические ограничения обсуждаем до выбора модели: какие данные пойдут в систему, где они будут храниться, нужна ли собственная инфраструктура. Подробнее — на странице внедрения ИИ в бизнес. Если вы только выбираете первую задачу для ИИ, начните со статьи «С чего начать внедрение ИИ в бизнес». Сравнить стоимость одной и той же нагрузки на GigaChat, YandexGPT и зарубежных моделях можно в калькуляторе стоимости ИИ-ассистента. Он пригодится, если правило «не дороже в полтора раза» войдёт в постановление.
Материал отражает тексты законов и найденные проекты актов на 19 ноября 2026 года. Когда выйдут постановления Правительства, я обновлю статью.
О технологиях и работе над проектами пишу в своём Telegram-канале.